新しいSQビルド125では、複数のデータレンジパーツが導入されます。これまでは、履歴データを2つのパートにしか分割できませんでした:
- サンプルにて –ここは、遺伝的進化を用いて戦略が進化させられる場所です。つまり、このデータ部分で戦略が評価され、その性能スコア(適応度)はこのデータ部分の指標から計算されます。この適応度によって、新しい世代を作り出すために集団内のどの戦略が交叉および突然変異の対象として選択されるかが決まります。最も優れた戦略がこれに選ばれる確率が最も高く、この仕組みのおかげで、集団全体として世代を経るごとに向上していくはずです。.
- アウトオブサンプル – これは進化のプロセスに含まれていなかったデータの「未知の」部分です。戦略が「未知の」データに対しても機能することを検証するために使用されます。.
遺伝的進化はこのデータ部分をとらえない。.
新しいビルド125では、さらに2つの可能なタイプが追加され、合計で4つになります:
- イン・サンプル・トレーニング – これはこれまで使用していたインサンプルと同じです。遺伝的アルゴリズムはこの部分を使用して適応度を決定し、集団内の戦略をランク付けします。.
- サンプル検証 ISV – SQ Xの新パーツで、ISTパートにおける戦略のパフォーマンスがISVパートでも維持されるかどうかを判定するために使用されるもの。.
機械学習では、トレーニングセット(IST)で訓練されたモデルが検証セット(Validation set)にも適用できるかどうかを判断するために使用されます。.
SQ Xでは、この部分で適応度が停滞した際に遺伝的進化を再起動するために使用できます。.
- 標本外 – これは以前と同様であり、進化の一部ではなかったデータの「未知の」部分を表しています。
- 取引なし – その部分ではストラテジーがトレードを行わないことを意味する特別な部分。例えば、データの中央にあるボラティリティの低い部分をスキップするために使用できます。.
機械学習における一般的な推奨事項は、履歴データをIST、ISV、OOSの3つの等しい部分に分割することです。.
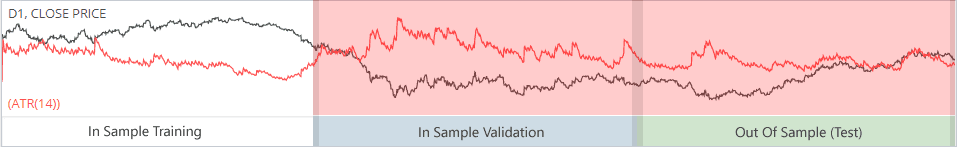
もう一つの分割方法としては60/20/20にするか、あるいはサンプル外期間を先頭に移動する方法があります。.
複数のデータセクション
SQ X B 125のもう一つの新しい機能は、定義できることです 複数の 標本内検証または標本外 部品, 、1つだけでなく、任意の順番で。.
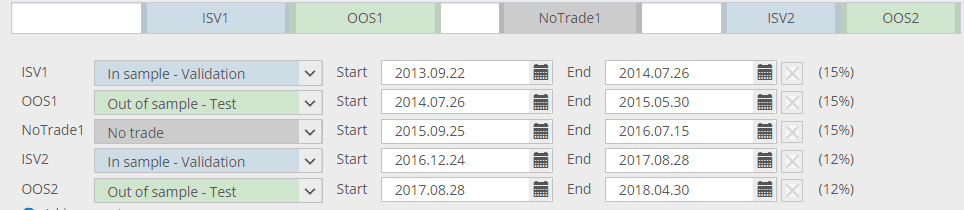
上の画像で白い部分はすべてインサンプル(標本内)のトレーニングであり、これらは戦略が進化する基となったデータです。.
青色(ISV)の部品は、戦略が検証されるデータであり、停滞しているときに進化を再開させることができる。.
グレーの部分(取引なし)は除外された部分であり、戦略はこの部分で取引を行いません。.
緑色の部分はOOS(サンプル外)のパーツです。これらは遺伝的進化の一部ではなく、戦略は未知のデータで評価されます。.
各セクションによる条件とフィルタリング
すべてのメトリクスが現在 これらの各部分についても個別に計算される, 、条件式の中で使用できます。.
たとえば、次のような条件を満たす戦略を除外することができます:純利益(OOS1)が、純利益(OOS2)の80%を下回るもの。.
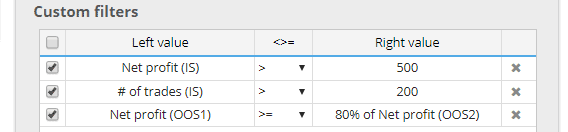
これにより、戦略がデータの複数の部分で優れたパフォーマンスを発揮する必要がある、「より厳格な」フィルタリングを使用できるようになります。.


 英語
 スペイン語
 ポルトガル語
 フランス語
 イタリア語
 ドイツ語

 エリー・ソウチコヴァ



ありがとうございます
ここで、純利益 (IS) についてですが、IS には IST、ISV1、ISV2 が含まれるということで合っていますか?
いい質問ですね。SQチームのどなたか答えていただけますか?
はい、その通りです
これが何を意味するのか理解しようとして、自分はとてもバカだと感じます。.
具体的な質問がございましたら、遠慮なくお尋ねください。
ISVとOOSの違いについて、機械学習の文脈も含めてもう少し詳しく説明しますね。 まず、前提として「ISV」と「OOS」は、機械学習の分野において全く異なる概念を指すことが多い用語です。それぞれの意味と違いを詳しく見ていきましょう。 --- ### 1. ISV (Independent Software Vendor:独立系ソフトウェアベンダー) * **基本的な意味:** 特定のハードウェアメーカー(AppleやMicrosoftなど)に属さず、自社で独自のソフトウェアを開発・販売している企業のことを指します。 * **機械学習の文脈でのISV:** AIや機械学習のアルゴリズム、モデル、またはそれらを利用したSaaS(サービスとしてのソフトウェア)を開発し、企業向けに販売している会社のことです。 * *例:* 特定の業界向けに画像認識AIソフトを開発・販売している企業はISVに該当します。自社でモデルを作るリソースがない企業は、ISVが提供するAIソリューションを購入して利用します。 --- ### 2. OOS (Out-of-Sample:標本外 / Out-of-Stock:在庫切れ) 機械学習や統計学の文脈で「OOS」と言われた場合、ほぼ確実に **Out-of-Sample(標本外)** の略です。 * **基本的な意味:** モデルの訓練(学習)に使用しなかったデータのことです。 * **機械学習の文脈でのOOS:** 機械学習モデルを構築する際、持っているすべてのデータを学習に使ってしまうと、「過去のデータには完璧に当てはまるが、新しいデータには全く対応できない(過学習・オーバーフィッティング)」という問題が起きます。 これを防ぐため、データを「訓練用データ(In-Sample)」と「テスト/検証用データ(Out-of-Sample)」に分割します。 * **IS (In-Sample / 標本内):** モデルが学習に使ったデータ。 * **OOS (Out-of-Sample / 標本外):** モデルが一度も見たことがない、未知のデータ。 * **なぜOOSが重要なのか?** AIモデルの本当の実力を測るには、**OOS(未知のデータ)に対してどれだけ正確に予測できるか**を確認する必要があります。学校のテストに例えるなら、ISは「事前に配られた練習問題(答え合わせ済み)」、OOSは「本番のテスト(見たことがない問題)」のようなものです。 --- ### まとめ:違いは何? * **ISV** は、AIやソフトウェアを**「作るビジネス側の主体のこと(企業)」**です。 * **OOS** は、AIモデルの精度を評価するために使う**「データの種類(未知のデータ)のこと」**です。 もし「機械学習のモデル評価」について話している文脈であれば、OOS(Out-of-Sample)のことである可能性が非常に高いです。
これはSQ Xのデータ部分で、IST(トレーニング部分)での戦略のパフォーマンスがISV部分でも維持されるかどうかを判断するために使用されます。SQ Xでは、この部分で適応度が停滞したときに遺伝的進化を再開するためにも使用できます。したがって、OOSで検証される前にパフォーマンスを検証するために使用される、一種のセミOOSです。
ちょっと質問なのですが…ランキングフィルターを「Full」に適用した場合、これらの要素はISVの部分にも適用されるのでしょうか?それとも「IST」に設定する必要がありますか?また、「IS」というオプションもありますが、SQX 139における「IS」と「IST」の違いは何ですか?
ありがとう
キム
はい、「フル」とは、すべてのデータと、oos(OutOfScope)部分も含まれているという意味です。
確認させてください。データを以下のように4つのセグメントに分けると….
OOS1、OOS2、ISV、IST
また、ランクフィルターには「Profi Factor (Full) > 1.3」のみを設定しました。
それは〜と言っているようなものです
Proフィット係数(OOS1) > 1.3
Proフィット係数 (OOS2) > 1.3
Proフィットファクター(ISV) > 1.3
Proフィット係数(IST) > 1.3
これは以前とは大きく異なるため
全データにおけるProfit係数(OOS1)>1.3
こんにちは、役立つ記事をありがとうございます。.
機械学習を最大限に活用するには、どの設定を使用すべきですか?
誠にありがとうございます。,
マーティン